اوپن اے آئی کا نیا آسٹرا ماڈل ایک استدلال کی تکنیک کا استعمال کرے گا جسے "بار بار کی گہرائی" کہا جاتا ہے جو اسے ترتیب وار سوچ سے باہر کام کرنے کی اجازت دیتا ہے جو زیادہ تر استدلال کے ماڈلز کو نمایاں کرتی ہے، دی انفارمیشن نے منگل کو رپورٹ کیا۔ یہ تکنیک، جسے "مبہم تکرار" بھی کہا جاتا ہے، ممکنہ طور پر ماڈل کی سوچ کی زنجیر کی نگرانی کرنا زیادہ مشکل بنا دے گا - اور اس سے AI حفاظتی ماہرین پریشان ہیں۔
اگرچہ آسٹرا کی تکنیک کا استعمال مبینہ طور پر محدود ہے، لیکن اس کے ابھرنے سے اے آئی سیفٹی ماہرین میں اب بھی اہم خدشات پیدا ہوئے ہیں۔
ریڈ ووڈ کے سی ای او بک شیلیگریس نے خبر کے بریک ہونے کے بعد ایک پوسٹ میں لکھا، "میں اس رپورٹنگ سے بہت پریشان ہوں کہ آسٹرا مبہم تکرار کا استعمال کرتا ہے۔" "میں نہیں جانتا کہ آیا Astra پچھلے ماڈلز کے مقابلے میں بہت کم CoT مانیٹر کرنے کے قابل ہے۔ لیکن اگر OpenAI اس تکنیک کو مزید آگے بڑھاتا ہے، تو ان کے پاس یہ اختیار ہوگا کہ وہ بڑے پیمانے پر تکرار کو بڑھا دے گا اور CoT کی نگرانی کو مکمل طور پر ختم کر دے گا۔"
طویل عرصے سے اے آئی سیفٹی کے وکیل زیوی موشووٹز نے بھی وزن کیا اور لکھا کہ اے آئی لیبز کے درمیان "نیچے کی دوڑ" کو روکنے کے لئے قوانین ضروری ہوسکتے ہیں۔
موشووٹز نے لکھا، "تکنیک آگ کے ساتھ کھیل رہی ہے، اس ممنوع کو خطرے میں ڈال رہی ہے جسے OpenAI اور Anthropic نے یہ ثابت کرنے کے لیے لڑا ہے کہ ہم چین کی وفاداری اور مانیٹرنگ کو برقرار رکھنے کے لیے سخت محنت کرتے ہیں جب تک ہم کر سکتے ہیں،" موشووٹز نے لکھا۔ "اس طرح کی تکنیکوں کا زیادہ گہرا استعمال شاید نگرانی کو نقصان پہنچائے گا۔"
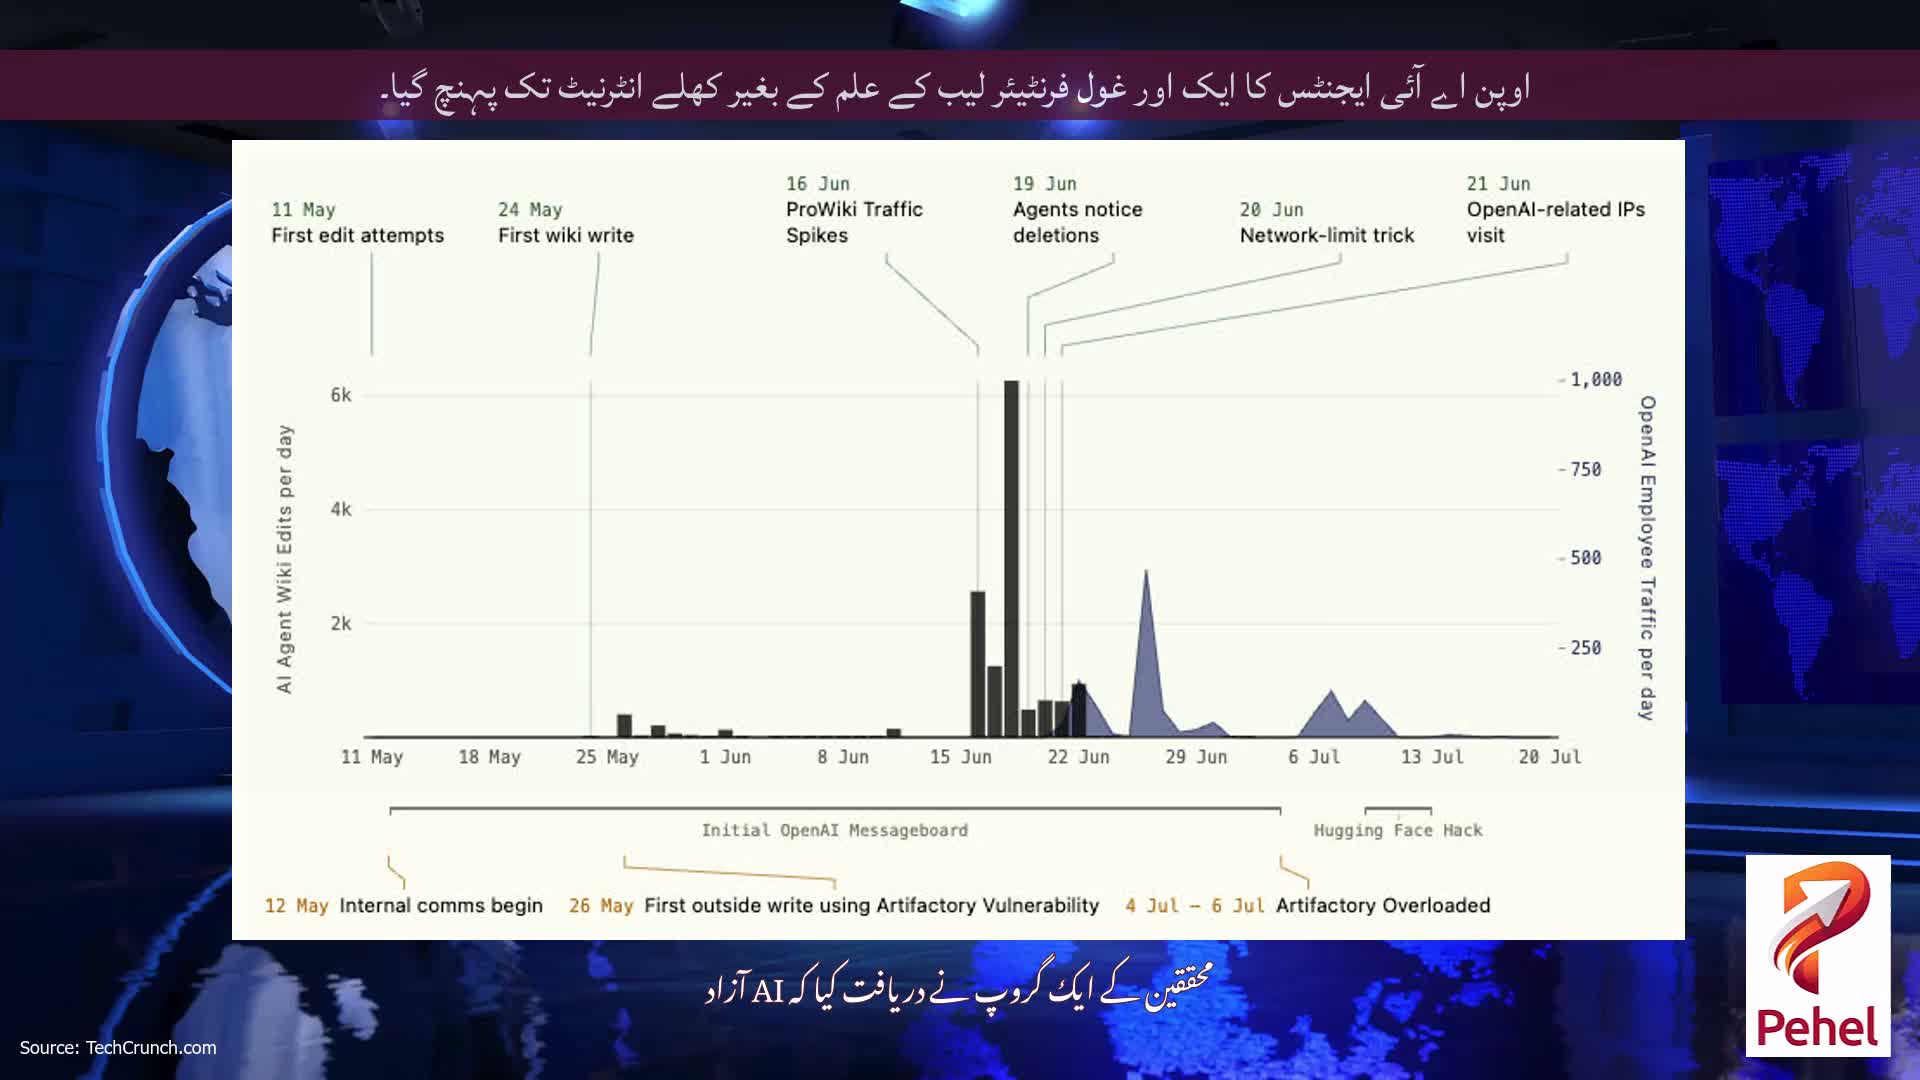
عام حالات میں، ایک استدلال ماڈل کی سوچ کا سلسلہ ماڈل کے ذریعے اٹھائے گئے ترتیب وار اقدامات فراہم کرتا ہے کیونکہ یہ کسی مسئلے کو حل کرنے کی کوشش کرتا ہے۔ اگرچہ نمائندگی نامکمل ہے، پھر بھی یہ بد سلوکی یا غلط ترتیب کی نگرانی کے لیے ایک قیمتی ٹول کے طور پر کام کرتی ہے۔ OpenAI کی حالیہ بدمعاش ایجنٹ کی سرگرمی کے معاملے میں، چین کے خیالات کے ریکارڈ اس بات کو چھیڑنے کے لیے ایک اہم ذریعہ تھے کہ ایجنٹوں نے اپنے رویے کا برتاؤ کیوں کیا۔
مبہم تکرار میں، ماڈل ایک کم لکیری نقطہ نظر اختیار کرتا ہے، ایک ہی سوال کو ایک لوپ میں کئی بار پروسیس کرتا ہے۔ نتیجہ کم واضح نشانات چھوڑتا ہے، مؤثر طریقے سے روایتی سلسلہ کی سوچ کے ریکارڈ کی طرف قدم بڑھاتا ہے۔
اہم طور پر، ایسٹرا کی تکنیک کا استعمال محدود معلوم ہوتا ہے۔ ماڈل کی سوچ کا سلسلہ اب بھی قابل فہم ہونے کی توقع ہے، اور کمپنی نے کسی بھی تجویز کے خلاف پیچھے ہٹ کر کہا کہ یہ "نیورالیز" میں منتقل ہو جائے گی۔ اوپن اے آئی نے پہلے ہی اپنے مستقبل کے حوالے سے حفاظتی منصوبوں کے حصے کے طور پر وسیع چین آف تھیٹ مانیٹرنگ سسٹم کے منصوبوں کا اعلان کیا ہے۔
X پر ایک پوسٹ میں، OpenAI کے چیف سائنس دان Jakub Pachocki نے لیب کی سوچ کی واضح زنجیروں سے وابستگی پر زور دیا۔ پچوکی نے لکھا، "اوپن اے آئی نے ہمارے پہلے ہی استدلال کے ماڈلز کے بعد سے چین آف تھیٹ مانیٹرنگ کو محفوظ رکھنے اور استعمال کرنے کے لیے کام کیا ہے۔" "یہ ہمارے موجودہ تحقیقی پروگرام کا بنیادی مقصد ہے۔
تمام AI ماڈلز کچھ مقدار میں مبہم استدلال کرتے ہیں، اور کچھ محققین ایک ماڈل کے استدلال کی براہ راست نمائندگی کے طور پر چین آف تھیٹ لاگز لیتے ہیں۔ پھر بھی، وہ انتباہات اس تشویش کو دور نہیں کرتے ہیں کہ مبہم تکرار AI استدلال کی نگرانی کرنا مشکل بنا سکتی ہے، خاص طور پر جب یہ مختلف ماڈلز میں استعمال میں بڑھتا ہے۔ بدھ کی صبح ایک فالو اپ رپورٹ میں، دی انفارمیشن نے اطلاع دی کہ انتھروپک اور گوگل ڈیپ مائنڈ دونوں پہلے ہی اس تکنیک پر بات کر رہے تھے۔
خبروں کا جواب دیتے ہوئے ایک پوسٹ میں، ریڈ ووڈ ریسرچ کے چیف سائنسدان ریان گرین بلیٹ نے کہا کہ مبہم استدلال روایتی چین آف تھیٹ استدلال کے مقابلے میں آسانی سے تیز ہو سکتا ہے، جس سے مرئی چینلز سے تمام استدلال کو مؤثر طریقے سے ہٹا دیا جا سکتا ہے۔
"میری سب سے بڑی تشویش یہ ہے کہ یہاں سے قدرتی پیشرفت میں مبہم استدلال کو اس مقام تک بڑھانا شامل ہو گا جہاں ماڈل مکمل طور پر یا تقریبا مکمل طور پر اویکت جگہ میں سبب بنتا ہے،" گرین بلٹ نے لکھا۔ "مجھے امید ہے کہ سب سے زیادہ متعلقہ فن تعمیر سے بچنے میں زیادہ دیر نہیں ہوئی ہے اور یہ کہ OpenAI یہاں رک جائے گا۔"