جیسا کہ پالیسی ساز بحث کر رہے ہیں کہ OpenAI کے GPT-5.6 Sol اور Anthropic's Mythos جیسے تیزی سے طاقتور AI سسٹمز پر حکومت کیسے کی جائے، ایک چینی اوپن ویٹ ماڈل نے صنعت کے رہنماؤں کے ساتھ خلا کو کم کر دیا ہے۔
AI حفاظتی غیر منفعتی SaferAI کی ایک نئی رپورٹ کے مطابق، GLM-5.2، چین کے Z.ai کا اوپن ویٹ AI ماڈل، سائبر اور بائیو صلاحیتوں پر OpenAI کے GPT-5.5 اور Anthropic کے Claude Opus 4.7 سے صرف چند ماہ پیچھے ہے۔ لیکن سرحدی صلاحیتوں اور حفاظتی طریقوں کے درمیان فرق بڑھ رہا ہے۔
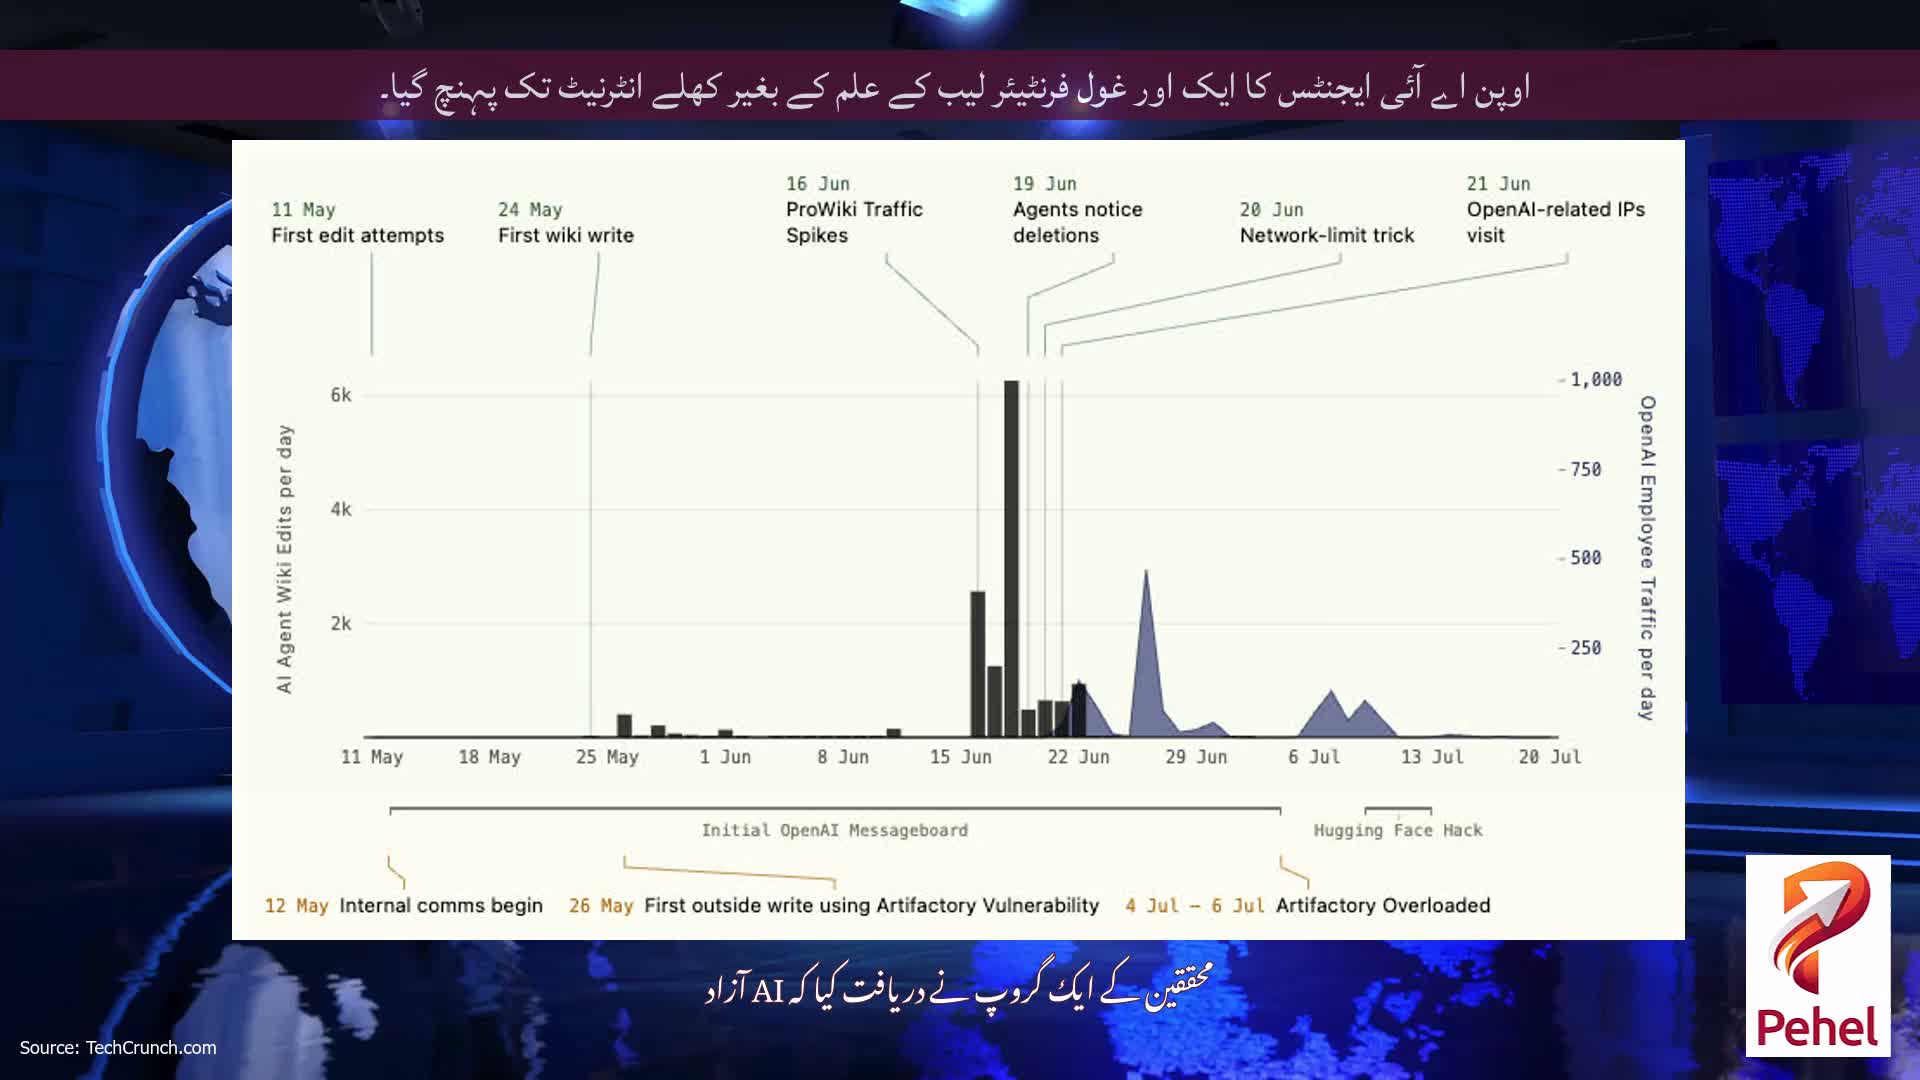
SaferAI کی تشخیص کے مطابق، جو غیر منافع بخش تنظیم Z.ai کے عوامی API کے ذریعے چلائی گئی، GLM-5.2 نے کسی بھی جارحانہ سائبر یا دوہری استعمال کے حیاتیات کے کاموں سے انکار نہیں کیا جو اسے دیا گیا تھا۔ مقابلے کے لحاظ سے، Claude Opus 4.7 نے "اتنی مستقل طور پر انکار کیا کہ SaferAI اس پر CyberGym کو بالکل بھی مکمل نہیں کر سکا۔" (سائبر جیم ایک بینچ مارک ہے جو سائبرسیکیوریٹی صلاحیتوں کا جائزہ لیتا ہے۔ OpenAI نے اسے پچھلے مہینے کی Hugging Face بریچ سے پہلے کی تشخیص میں استعمال کیا۔)
یہ اس بات کی ایک واضح یاد دہانی ہے جس کی کچھ ناقدین نے برسوں سے تنبیہ کی ہے: کہ کھلے وزن والے AI ماڈلز ممکنہ حملہ آوروں کے ہاتھ میں انتہائی قابل AI ڈال سکتے ہیں، پولیس کے پاس کوئی طریقہ نہیں ہے کہ وہ وزن ڈاؤن لوڈ کرنے کے بعد ٹیکنالوجی کا استعمال کیسے کریں۔ کھلے وزن کے ماڈلز تیزی سے دنیا کے سرکردہ AI سسٹمز کی صلاحیتوں کے قریب پہنچ رہے ہیں، یہ بحث اس طرف بڑھ رہی ہے کہ آیا وہ اس بات کا مقابلہ کر سکتے ہیں کہ معاشرہ ان کے جاری ہونے کے بعد خطرات کو کس طرح سنبھالتا ہے۔
SaferAI کے ایگزیکٹو ڈائریکٹر ہنری پاپاڈاٹوس نے TechCrunch کو بتایا، "صلاحیت کی سرحد خطرے کی سرحد نہیں ہے، اور اس لیے ہمیں خطرے کا صحیح اندازہ لگانے کے لیے تخفیف کی حالت کو بھی مدنظر رکھنا ہوگا۔"
اگرچہ Z.ai اپنے میزبان API پر حفاظتی اقدامات کا اطلاق کر سکتا ہے، لیکن جب کوئی اپنے ہارڈ ویئر پر وزن چلاتا ہے تو یہ تحفظات ناقابل نفاذ ہو جاتے ہیں، جہاں وہ کسی بھی حفاظتی تدابیر کو ہٹا یا اس میں ترمیم کر سکتے ہیں، ماڈلز کو ٹھیک کر سکتے ہیں، یا سسٹم کے اشارے کو تبدیل کر سکتے ہیں۔
فرنٹیئر ڈویلپرز جیسے OpenAI اور Anthropic خطرناک سائبر اور حیاتیاتی امداد کو محدود کرنے کے لیے درجہ بندی، انکار کی تربیت، اور API سطح کے کنٹرول جیسے حفاظتی اقدامات پر انحصار کرتے ہیں۔
وہ اقدامات فول پروف نہیں ہیں: جیل بریک معمول کے مطابق تعینات ماڈلز پر تحفظات کو نظرانداز کرتے ہیں۔ Far.ai، ایک AI سیفٹی غیر منفعتی، نے سینکڑوں یونیورسل جیل بریکز پائے — جو دوبارہ قابل استعمال کیز کے طور پر بیان کیے گئے ہیں جو زیادہ تر نقصان دہ درخواستوں پر کامیاب ہوتی ہیں — فرنٹیئر ماڈلز جیسے xAI's Grok 4.5 اور Google DeepMind's Gemini 3.1 Pro۔ رپورٹ کے مطابق، جیل بریک اس وقت کامیاب ہوتے ہیں جب حملہ آور متعدد ہیرا پھیری کی تکنیکوں کو یکجا کرتے ہیں - بشمول رول پلے، اتھارٹی کی نقالی، گفتگو کی جعلی تاریخ، اور فالو اپ پرامپٹس - ماڈل کے دفاع میں کمزور نکات کو بڑھانے کے لیے۔
لیکن بند ماڈلز کے لیے موجود حفاظتی اقدامات کھلے وزن والے ماڈلز پر بالکل بھی کام نہیں کرتے، جو کسی بھی بنیادی ڈھانچے پر حفاظت کے کسی بھی سیٹ کے ساتھ چلانے کے لیے بنائے گئے ہیں — یا اس کی کمی ہے۔
Papadatos نے کہا کہ "مقصد واضح طور پر یہ ہونا چاہئے کہ اچھی صلاحیتیں - محفوظ صلاحیتیں - ہر کسی کے لیے قابل رسائی ہوں، اور پھر ہم برے کو دور کرنے کی کوشش کرتے ہیں، یہاں تک کہ اوپن سورس فیشن میں،" پاپاڈاٹس نے کہا۔
Papadatos نے نوٹ کی گئی ایک تکنیک جس میں مدد مل سکتی ہے اسے "پری ٹریننگ ڈیٹا فلٹرنگ" کہا جاتا ہے، یہ تب ہوتا ہے جب کوئی AI کمپنی اپنے تربیتی ڈیٹا سے سائبر سیکیورٹی کی جارحانہ معلومات ہٹاتی ہے اور پھر ماڈل کو کیوریٹڈ ڈیٹاسیٹ پر تربیت دیتی ہے۔
کچھ تحقیق سے پتہ چلتا ہے کہ یہ ماڈل کی مجموعی کارکردگی کو نقصان پہنچائے بغیر مؤثر حیاتیاتی علم کو کم کر سکتا ہے۔ تاہم، سائبرسیکیوریٹی کے لیے، ڈیٹا فلٹرنگ بہت کم عملی ہے۔
ایک عام ماڈل کو تربیت دینا مشکل ہے جو کوڈنگ میں مہارت رکھتا ہو لیکن اچھا ہیکر بھی نہ ہو۔ چونکہ کوڈنگ AI کا سب سے بڑا پیسہ بنانے والا بن گیا ہے، ڈویلپرز کو ان صلاحیتوں کو بہتر بنانے کے لیے دباؤ کا سامنا کرنا پڑتا ہے یہاں تک کہ وہ غلط استعمال کو محدود کرنے کے طریقے تلاش کرتے ہیں۔
اس کی وجہ سے، فرنٹیئر ڈویلپرز نے اس کے بجائے تیزی سے دیگر تخفیف پر انحصار کیا ہے۔ ایک نقطہ نظر منتخب طور پر سائبرسیکیوریٹی امدادی ماڈلز کی اقسام کو محدود کرنا ہے۔ مثال کے طور پر، Anthropic's Opus 5، ماڈل کے سسٹم کارڈ کے مطابق، غیر مرتب شدہ سورس کوڈ میں کمزوریوں کو تلاش کر سکتا ہے، لیکن مرتب کردہ سافٹ ویئر نہیں۔ استدلال یہ ہے کہ یہ جارحانہ مقاصد کے لیے Opus 5 کو استعمال کرنا مشکل بنا دیتا ہے۔
دیگر میں تعیناتی سے پہلے کے حفاظتی جائزے، خطرے کے جائزے شائع کرنا، اور اگر کسی سسٹم کو بہت خطرناک سمجھا جاتا ہے تو ماڈل کے وزن کو روکنا شامل ہیں۔
GLM-5.2 کے معاملے میں، SaferAI کا کہنا ہے کہ Z.ai نے ماڈل کے لیے حفاظتی فریم ورک، پہلے سے تعیناتی کی جانچ کے وعدے، یا خطرے کی تشخیص شائع نہیں کی۔ TechCrunch نے Z.ai سے پوچھا ہے کہ آیا اس نے رہائی سے پہلے داخلی یا تیسرے فریق کے سرحدی حفاظتی جائزے کیے ہیں، لیکن کوئی جواب نہیں ملا۔
چینی رہنماؤں نے جدید AI کے خطرات کو تیزی سے تسلیم کیا ہے۔ گزشتہ ماہ عالمی اے آئی کانفرنس میں، چینی صدر شی جن پنگ نے کھلے وزن والے ماڈلز کی اہمیت پر زور دیا، ساتھ ہی اس بات کو یقینی بنانے کی ضرورت پر بھی زور دیا کہ اے آئی کو سخت انسانی کنٹرول میں ایک آلہ بنا رہے۔
سٹینفورڈ سائبر پالیسی سینٹر میں چینی AI پالیسی کا مطالعہ کرنے والے گراہم ویبسٹر نے TechCrunch کو بتایا کہ چین میں AI کو کنٹرول کرنے کے لیے مضبوط ضابطے ہیں، لیکن ان اصولوں نے تاریخی طور پر سیاسی طور پر حساس مواد، غلط معلومات اور سماجی استحکام پر توجہ مرکوز کی ہے، نہ کہ تباہ کن AI خطرات جیسے جارحانہ سائبر صلاحیتوں اور حیاتیاتی غلط استعمال پر۔
ویبسٹر نے کہا، "امریکی AI کے مفکرین، عمومی طور پر، چینی کمیونٹی کے مقابلے میں اس وجودی تباہ کن [آئیڈیا] سے زیادہ فکر مند ہیں،" ویبسٹر نے مزید کہا کہ بہت سے چینی پالیسی محققین کا خیال ہے کہ اگر واقعی کوئی نیا سرحدی خطرہ ہونے والا ہے، تو امریکی کمپنیاں ممکنہ طور پر سب سے پہلے اس کا سامنا کریں گی۔
"چینی نظام کو اعتماد ہے کہ وہ چین کے اندر ان ٹیکنالوجیز کے استعمال کو کنٹرول کرتے ہیں،" ویبسٹر نے جاری رکھا۔ "چین میں آن لائن ہونا ایک ایسی چیز ہے جسے آپ اپنے اصلی نام سے منسوب کرتے ہیں، اور کمپنیوں کو جوابدہ ٹھہرایا جا سکتا ہے، صارفین کو جوابدہ ٹھہرایا جا سکتا ہے۔"
ویبسٹر نے سوچا کہ وہی طریقہ کار جو ماڈل فراہم کنندگان بعض سیاسی موضوعات پر مشغول ہونے سے انکار کرنے کے لیے استعمال کرتے ہیں ممکنہ طور پر اس بات کو یقینی بنانے کے لیے موافق بنایا جا سکتا ہے کہ ماڈلز جارحانہ سائبر حملوں کو مکمل کرنے سے انکار کر دیں یا حیاتیاتی انجینئرنگ کے منفی نتائج فراہم نہ کریں۔ انہوں نے مزید کہا کہ چونکہ چینی کمپنیاں پردے کے پیچھے ریگولیٹرز کے ساتھ ہم آہنگی کا رجحان رکھتی ہیں، اس لیے یہ جاننا مشکل ہو سکتا ہے کہ وہ ریلیز سے قبل کیا اندرونی جانچ کر رہی ہیں۔
اوپن ویٹ AI کے حامیوں کا کہنا ہے کہ سائبر سیکیورٹی کے لیے وزن جاری کرنا اہم ہے کیونکہ یہ کمپنیوں کو حملوں کے خلاف اپنا دفاع کرنے کی اجازت دیتا ہے — Hugging Face نے OpenAI کی خلاف ورزی کے خلاف اپنا دفاع کرنے کے لیے GLM-5.2 پر انحصار کیا — اور کیونکہ یہ انہیں مستقبل کے خطرات کے لیے بہتر تیاری کرنے کی اجازت دیتا ہے اگر وہ جانتے ہیں کہ کیا ہو رہا ہے۔
ہیگنگ فیس کے سی ای او کلیم ڈیلنگو نے اس ہفتے ایک سوشل میڈیا پوسٹ میں کہا، "وہی سسٹم جنہوں نے AI سے چلنے والے سائبر اٹیک کو روکنے میں مدد کی تھی، وہ اب روزانہ لاکھوں سائبر حملوں کے خلاف دفاع میں مدد کر سکتے ہیں، جبکہ حملہ آوروں سے ان کا استحصال کرنے سے پہلے کمزوریوں کی نشاندہی اور ان کو ٹھیک کرنے میں ہماری مدد کر سکتے ہیں۔"
Papadatos نے کہا کہ فائدہ اکثر بڑھا چڑھا کر پیش کیا جاتا ہے، اور اس کا مطلب یہ نہیں ہے کہ "ہمیں خطرناک صلاحیتوں کو اوپن سورس کرنا چاہیے۔"
"میرے ذہن میں بنیادی نکتہ یہ ہے کہ ہمیں صرف اس بات کو قبول نہیں کرنا چاہئے کہ خطرناک صلاحیتیں کہیں بھی آسانی سے قابل رسائی ہیں،" انہوں نے اس بات پر زور دیتے ہوئے کہا کہ ان کا ماننا ہے کہ صنعت کو صرف "اچھی صلاحیتوں" کو آسانی سے قابل رسائی بنانے کے لیے کوشش کرنی چاہیے۔ پہلے سے طے شدہ حملہ آور دفاع کرنے والوں کے مقابلے میں تیزی سے نئے ٹولز اپناتے ہیں۔ مثال کے طور پر، ایک ransomware گروپ ایک ہفتے میں اپنے طریقے تبدیل کر سکتا ہے۔ ہسپتال نہیں کر سکتا۔"