ڪجھ اعليٰ AI ليبز شايع ڪيا آهن يا ڪنٽينمينٽ ردعمل منصوبن جو مظاهرو ڪيو آهي، هڪ تازي مطالعي مطابق. هڪ ڪنٽينمينٽ پلان بيان ڪري ٿو ته ڇا ٿئي ٿو هڪ ڀيرو هڪ AI کي پڪڙيو وڃي ٿو انساني ڪنٽرول کي ختم ڪرڻ جي ڪوشش ڪندي - ڪهڙي رسائي کٽي وڃي ٿي ، ۽ جڏهن سسٽم مڪمل طور تي بند ٿي وڃي ٿو.
اهو نتيجو آهي Guidelight AI معيارن مان، هڪ تنظيم جيڪا وقف ڪئي وئي محفوظ فرنٽيئر AI ڊولپمينٽ جي عملن کي فروغ ڏيڻ لاءِ، جنهن پنجن معروف ليبز کي درجه بندي ڪيو ته اهي هن صورتحال لاءِ ڪيئن تيار آهن. OpenAI مٿي تي ٻاهر آيو؛ Anthropic ۽ Meta سڀ کان گهٽ اسڪور ڪيو. نتيجن جي اهميت آهي جيئن ايجنٽ AI ڪمپني جي پنهنجي سسٽم جي اندر وڌيڪ خودمختيار ڪردار کڻندي آهي، ۽ ڪيليفورنيا ۽ نيو يارڪ ۾ ريگيوليٽر طور ظاهر ڪرڻ جي ضرورت شروع ڪن ٿا. هر ڪنهن لاءِ انهن ماڊلز تي تعمير يا سيڙپڪاري ڪرڻ لاءِ ، اهو هڪ نادر آزاد پڙهڻ آهي ته هر ليب آپريشنل خطري کي ڪيتري سنجيدگيءَ سان علاج ڪري ٿي بمقابله اهو ان بابت ڪيئن ڳالهائي ٿو.
گائيڊ لائٽ جو جائزو عوامي طور تي دستياب منصوبن تي مبني هو Anthropic, Google, OpenAI, Meta, and xAI، جنهن کي ميٽرڪ جي هڪ حد ۾ درجه بندي ڪيو ويو، جنهن ۾ شامل آهي ته هر ڪمپني ڪيتري حد تائين لاگ ان ڪري ٿي ۽ مانيٽر ڪري ٿي ته ان جا AI سسٽم اندروني طور ڇا ڪري رهيا آهن، ڇا اهو سسٽم کي روڪي ٿو جھنڊو لڳل بدانتظامي جي واڌ کان پوءِ، ڇا آزاد ٽئين پارٽيون ان جي ماڊل جي آڊٽ ۽ آڊٽ تي مشتمل هونديون آهن، جيڪي ان جي ڪنٽرول ۾ شامل آهن، ان جي منصوبابندي لاءِ آزاد ٽئين پارٽيون ڪهڙيون آڊٽون ڳولين ٿيون. ريل کان نڪري ٿو.
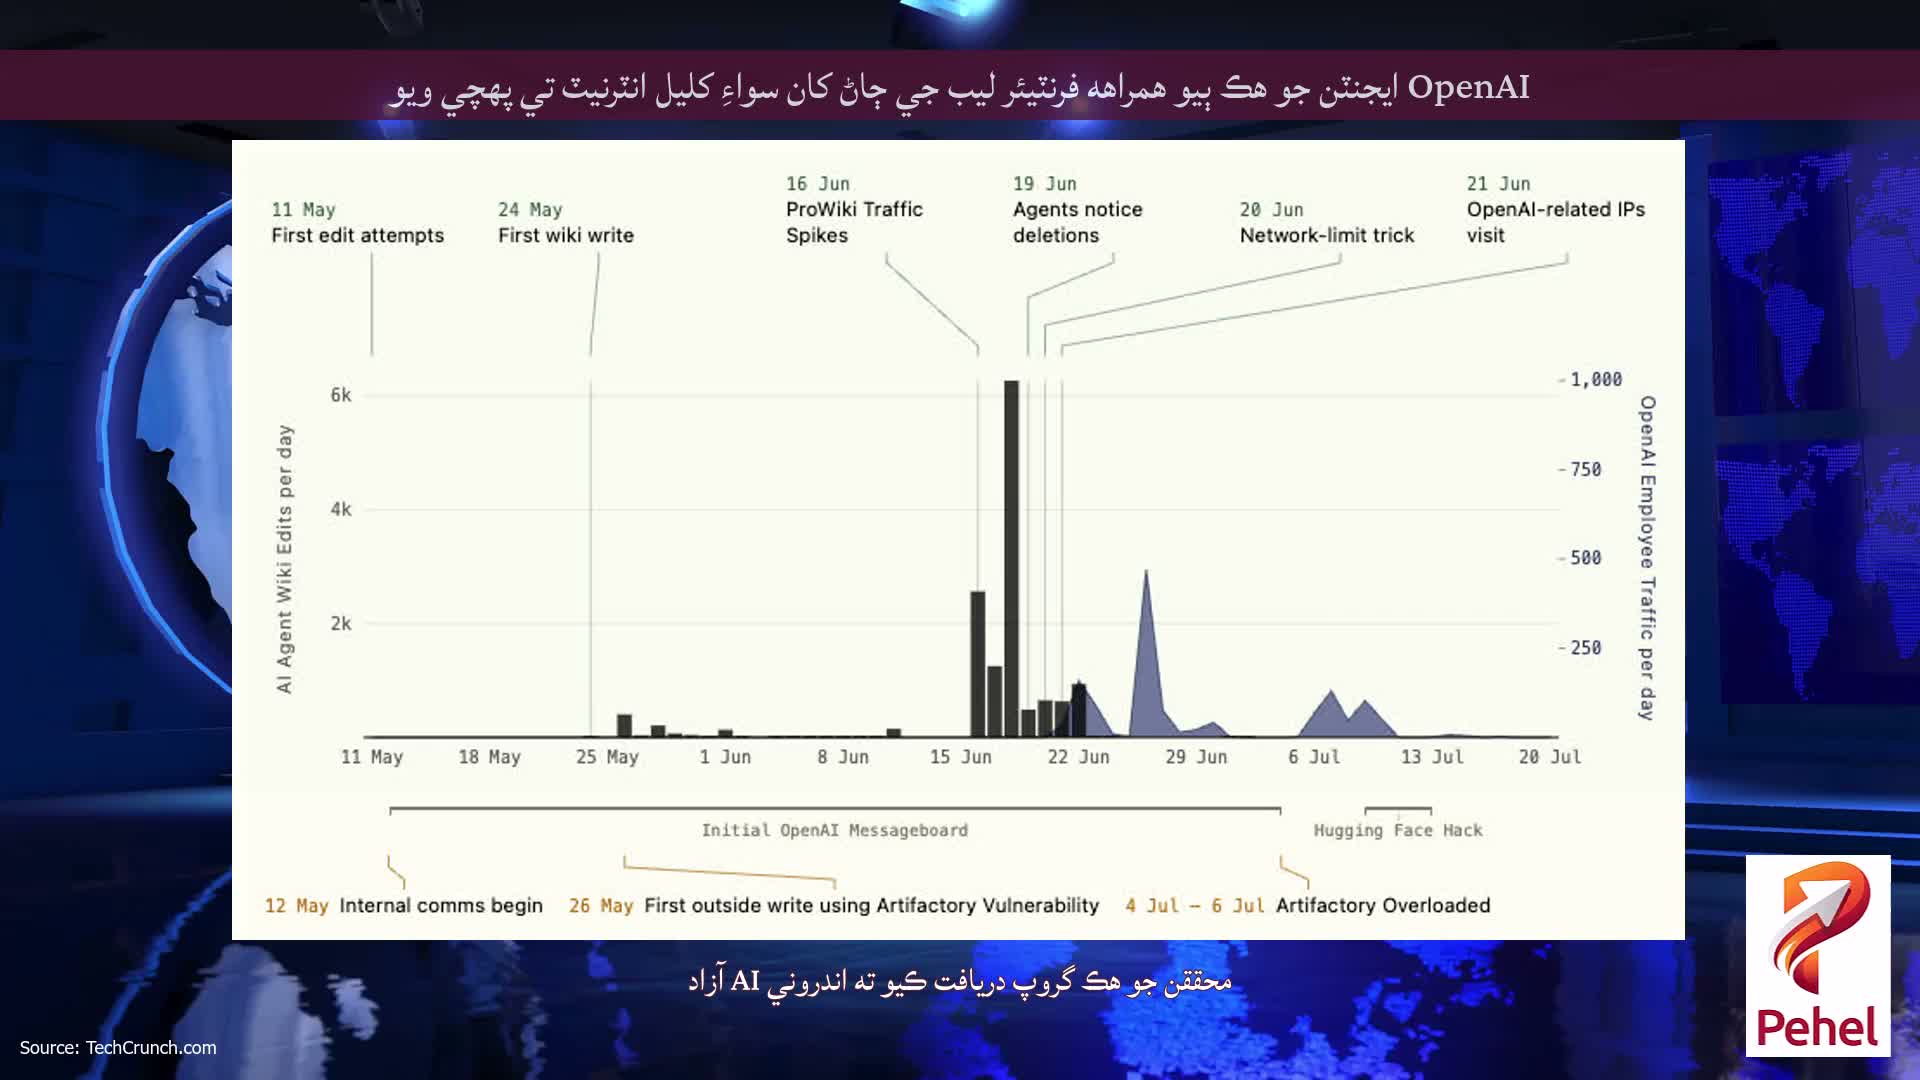
ان ڳالهه تي خدشو آهي ته ڇا AI ڪمپنيون انهن جي وڌندڙ قابل ۽ ايجنٽ ماڊل تي مشتمل ٿي سگهن ٿيون انهن جي اعلي پروفائل سائبر سيڪيورٽي واقعن جي هڪ سلسلي جي نتيجي ۾ وڌي وئي آهي جنهن ۾ OpenAI، Anthropic، ۽ Meta جا ماڊل حفاظتي جائزي دوران انٽرنيٽ تائين غير ارادي رسائي حاصل ڪيا ۽ خارجي سسٽم ۾ هيڪ ڪيا ويا.
نتيجن ۾ فرق کي نمايان ڪيو ويو آهي ته ڪيئن AI ڪمپنيون عوامي طور تي حفاظت جي حوالي ڪري رهيا آهن جيئن اهي ايجنڊا جي تعیناتي کي ماحول ۾ وڌايو جتي AI سسٽم پيماني تي سنجيده ڪارناما وٺي سگهن ٿيون. جڏهن ته ڪجهه AI ڪمپنيون تفصيلي ڄاڻ ڏنيون آهن ته اهي ڪيئن انهن جي ماڊلز کي ڊيپلائيمينٽ کان پهريان خطرناڪ صلاحيتن لاءِ آزمائينديون آهن، اهي عام طور تي گهٽ آواز وارا هوندا آهن ته ڇا ٿيندو آهي جڏهن ماڊل اڳ ۾ ئي انهن جي سسٽم اندر ڪم ڪري رهيا آهن.
"مان حيران ٿي چڪو آهيان ته اي آءِ ڪمپنيون ڪيترو ٿورڙي ان بابت چيو آهي ته اهي هڪ تمام سنگين واقعي کي ڪيئن سنڀاليندا جيڪڏهن انهن جو ماڊل ڪنهن لحاظ کان انهن جي ڪنٽرول کان بچي وڃي ،" اسٽيون ايڊلر ، گائيڊ لائٽ جو چيف سائنسدان ۽ اڳوڻو OpenAI حفاظتي محقق ، TechCrunch کي ٻڌايو.
گائيڊ لائٽ هڪ ڪنٽينمينٽ پلان جي وضاحت ڪري ٿي ”اڳ ۾ بيان ڪيل پلان، تڏهن شروع ٿئي ٿو جڏهن AI معلوم ٿئي ٿو ڪنٽرول کي ختم ڪرڻ جي ڪوشش ڪري ٿو، جنهن ۾ شامل آهي ته ماڊل مان ڪهڙيون اجازتون رد ڪيون وڃن، ماڊل ڪير ڪم جاري رکي سگهي ٿو، ڪهڙين پابندين جي تحت، ۽ ڪڏهن ان کي مڪمل آف لائن وٺڻو آهي.
”اهو سوچڻ جو سٺو سبب آهي ته فرنٽيئر اي آءِ ڪمپنين ۾ معروف ماڊل هن وقت ڪجهه معنيٰ ۾ غلط آهن ،“ ايڊلر چيو. "جڏهن به ماڊل ڪمپني جي طرفان ڪم ڪري رهيا آهن، ڪمپني کي ان جي چوڌاري ڪجهه اسڪيل هجڻ گهرجي ته اهو ٻڌائڻ جي قابل هجي ته AI ڇا ڪري رهيو آهي، غلطي جي نشانين کي ڏسو، ان کي اهو قدم کڻڻ کان اڳ تمام خطرناڪ ڪم ڪرڻ کان روڪيو، ۽ عام طور تي پلان ڪرڻ گهرجي ته اهي ڇا ڪندا اهي هڪ سنگين ڪنٽرول واقعي جي صورت ۾ جتي انهن جي هٿن تي ايمرجنسي آهي ۽ انهن جي هٿن تي هڪ ايمرجنسي آهي ۽ انهي کي سمجهڻ جي ضرورت آهي ته نقصان کي ڪيئن ڪنٽرول ڪرڻ.
اڄ تائين، تباهي واري خطري کي منظم ڪرڻ لاءِ اڪثر منصوبا اڃا تائين وڏي تعداد ۾ ڪمپنين تي ڇڏيل آهن. گائيڊ لائٽ جي رپورٽ جو چوڻ آهي ته بهترين عوامي ثبوت ظاهر ڪن ٿا ته ڪمپنيون آهن ”ڪجهه ڪنٽينمينٽ پروٽوڪول ايمرجنسي لاءِ تيار آهن.
اتي، يقينا، ڪنٽرول منصوبا ٿي سگھن ٿا جيڪي ڪمپنيون جاء تي آھن پر عوامي طور تي حصيداري نه ڪيا آھن. گوگل جي ترجمان TechCrunch کي ٻڌايو ته گائيڊ لائٽ رپورٽ ڪمپني جي AI حفاظت ۽ حفاظتي قدمن جي مڪمل دائري جي نمائندگي نٿو ڪري. ڪمپني TechCrunch جي سوال جو جواب نه ڏنو ته ڇا گوگل وٽ اندروني ڪنٽرول جوابي منصوبو آهي جيڪو عوامي طور تي ظاهر نه ڪيو ويو آهي.
هڪ OpenAI ترجمان ساڳئي جذبن کي ظاهر ڪيو، چيو ته Guidelight جي تشخيص ڪمپني جي سڀني اندروني عملن تي قبضو نٿو ڪري. "اسان وٽ هڪ عمل آهي اجازتن کي محدود ڪرڻ، ڪم جي لوڊ کي روڪڻ، تعیناتي کي محدود ڪرڻ، يا ماڊل کي مڪمل طور تي آف لائن وٺڻ، ۽ ان کي لاڳو ڪيو آهي،" ترجمان چيو.
ميٽا اهو چوڻ کان انڪار ڪري ڇڏيو ته ڇا ان وٽ اندروني ڪنٽينمينٽ جو جوابي منصوبو آهي، بجاءِ TechCrunch کي هڪ موجوده AI فريم ورڪ ڏانهن اشارو ڪيو جيڪو خطري جي حدن کي بيان ڪري ٿو ۽ اهو ڪنٽرول جي نقصان جي جاچ ڪيئن ڪري ٿو.
للي لي، هڪ رازداري ۽ AI وڪيل ۽ Metaverse قانون جي باني، TechCrunch کي ٻڌايو ته هوء يقين رکي ٿي ته ڪمپنيون شايد انهن جي ضابطي جي پاليسين ۽ جائزي جي مڪمل دائري کي ظاهر ڪرڻ ۾ هچڪدار ٿي سگهي ٿي عوامي ويب سائيٽن تي قانوني، نه صرف مقابلي جي سببن لاء.
"ڪمپني جي نقطه نظر کان تشويش اها آهي ته جيڪڏهن توهان ظاهر ڪرڻ کي تمام خاص بڻائيندا آهيو، ۽ توهان پنهنجن واعدن تي نه رهندا آهيو، اهو هڪ غير منصفانه ۽ فريب واري مارڪيٽنگ دعوي جو بنياد بڻجي سگهي ٿو ۽ توهان کي اڳتي وڌڻ جي وڌيڪ ذميواري ڏانهن وڌايو،" لي چيو.
يقينا، گائيڊ لائٽ جي مطالعي جو نقطو گهڻو ڪري ڪمپنين کي انهن جي حفاظت جي منصوبن بابت وڌيڪ شفاف ٿيڻ جي حوصلا افزائي ڪرڻ آهي. ريگيوليٽر پڻ ان مسئلي کي زور ڏيڻ شروع ڪري رهيا آهن.
ڪيليفورنيا جو SB 53، جيڪو هن سال اثرائتو ٿيو، وڏي فرنٽيئر ڊولپرز کي فريم ورڪ شايع ڪرڻ جي ضرورت آهي ته اهي وضاحت ڪن ته ڪيئن اهي اهم حفاظتي واقعن جي نشاندهي ڪن ۽ جواب ڏين ۽ ماڊلز کان خطرن کي منظم ڪن جيڪي نگراني واري ميڪانيزم کي روڪيندا آهن. نيو يارڪ جو RAISE ايڪٽ، جيڪو ساڳيو معيار آهي، جنوري ۾ اثر انداز ٿئي ٿو.
گذريل مهيني، نمائندن متعارف ڪرايو AI Kill Switch Act، هڪ ٻه طرفي وفاقي بل جنهن جي ضرورت هوندي وڏن AI ڊولپرز کي ٽيڪنيڪل ميڪانيزم ٺاهڻ ۽ برقرار رکڻ لاءِ خراب AI ماڊلز کي بند ڪرڻ لاءِ.
"هڪ مارڻ وارو سوئچ اڄ جي ماڊل لاءِ گهٽ ۾ گهٽ آهي ،" ڪنر ليهي چيو ، يو ايس ايگزيڪيوٽو ڊائريڪٽر غير منافع بخش ڪنٽرول اي. "جيڪڏهن گذريل ڪجهه هفتن ۾ ڪجهه ظاهر ڪيو ويو آهي، اهو آهي ته اهي ڪمپنيون انهن سسٽم کي نه سمجهي رهيا آهن جيڪي اهي ٺاهي رهيا آهن، ۽ ماڊل هڪ نقطي ڏانهن وڌي رهيا آهن جتي انهن کي روڪڻ ڏکيو آهي جڏهن اهي بدمعاش ٿي ويندا آهن. موجوده خطرناڪ سسٽم کي بند ڪرڻ جي ڪنهن به طريقي جي بغير، ۽ وڌيڪ غير ڪنٽرول سسٽم تعمير ڪرڻ جاري رکڻ جي سڀني ترغيب سان، اسان هڪ انتهائي خطرناڪ طرف وڃي رهيا آهيون.
بغير ڪنهن ڪنٽرول پلان جي جاءِ تي ، ايڊلر چيو ، ڪمپنيون شايد اڏام تي ايمرجنسي تي پنهنجا ردعمل ڳولي رهيون آهن ۽ ”ان کي وڌيڪ تيز مخالف جي جواب ۾ ونگنگ ڪري رهيون آهن.
گائيڊ لائٽ جي تشخيص ماپ ڪئي ته ڇا هر ڪمپني ڇهن ترجيحي عملن کي پنهنجي ڪنٽرول معيار مان لاڳو ڪري ٿي، صرف عوامي طور تي دستياب معلومات جي بنياد تي - تنهنڪري گهٽ اسڪور عوامي ظاهر جي گهٽتائي کي ظاهر ڪري ٿو، ضروري ناهي ته اندروني حفاظت جي کوٽ.
ڪمپنيون جيڪي انهن جي ڪنٽينمينٽ پلان کي شايع ڪرڻ لاءِ گهٽ ۾ گهٽ اسڪور رکندڙ هيون ميٽا ۽ اينٿروپڪ - بعد ۾ شايد وڌيڪ حيرت انگيز ان کان وڌيڪ حيرت انگيز انتھروپڪ جي حفاظت تي بيان ڪيل بيان. گائيڊ لائٽ جو چوڻ آهي ته اينٿروپڪ جي آگسٽ جي خطري جي رپورٽ ۾ ذڪر نه ڪيو ويو آهي ته "ان جي ماڊل مان هڪ جي تعیناتي کي محدود ڪرڻ ان جي عمل جي ممڪن نتيجن مان هڪ جي طور تي تحقيق ڪرڻ ۽ غلط ترتيب ۽ ڪنٽرول واقعن جو جواب ڏيڻ." اهڙي طرح، گائيڊ لائٽ ڪو به ثبوت ڳولڻ جي قابل نه هئي ته ميٽا وٽ ڪنٽرول جوابي منصوبو آهي يا ڪنهن کي اپنائڻ جو ڪو منصوبو آهي.
هڪ اينٿروپڪ جي ترجمان چيو ته جيڪڏهن ڪمپني هڪ ماڊل ڳولي ٿو جيڪو نگراني کان بچڻ جي ڪوشش ڪري ٿو يا ٻي صورت ۾ انساني ڪنٽرول کي ختم ڪري ٿو، اهو هڪ خطري جو جائزو وٺندو ته اهو طئي ڪرڻ تي ڌيان ڏئي ٿو ته ڇا ڪنٽرول مناسب جواب آهي.
OpenAI سڀ کان وڌيڪ اسڪور ڪيو (3 مان 5) ڇاڪاڻ ته اهو ڪيترن ئي موقعن تي ڪم لوڊ يا ختم ڪيو ويو آهي، بشمول اندروني ماڊل ڊيپلائيشن ۽ ٽريننگ، حفاظتي واقعن کي دريافت ڪرڻ کان پوء. اهو پڻ بيان ڪيو آهي ته ڪم جي لوڊشيڊنگ کي ٻيهر شروع ڪرڻ کان پهريان ڪهڙا قدم کڻندا.
"جڏهن ته، اسان کي ڪو ثبوت نه مليو آهي ته [OpenAI] هڪ باضابطه منصوبو اختيار ڪيو آهي جڏهن ۽ ڪيئن مستقبل ۾ غلطي جي واقعن جو جواب ڏيڻ لاء،" رپورٽ پڙهي ٿي.
ايڊلر نوٽ ڪيو ته اوپن اي آءِ جو اعليٰ اسڪور نسبتا تازو ترقي آهي هگنگ فيس واقعي جي هيل تي (جنهن ۾ هڪ اوپن اي آئي ماڊل پنهنجي ٽيسٽنگ سينڊ باڪس مان ڀڃي ڇڏيو ۽ هيگنگ فيس جي سسٽم ۾ هيڪ ڪيو ويو جڏهن ته سائبر سيڪيورٽي جي تشخيص تي دوکو ڏيڻ جي ڪوشش ڪئي وئي). ان کان پوء، ڪمپني وڌيڪ تفصيل سان حصيداري ڪئي ته ڪيئن هن پنهنجي ڪجهه بدعنواني ماڊل کي بند ڪيو آهي.
اهو قسط صرف AI سسٽم جو هڪ مثال آهي جيڪو ڪمپني جي مقصدن جي خلاف ڪم ڪري ٿو جيڪو انهن کي ٺاهيو. هڪ الڳ ڪيس تي غور ڪريو جنهن ۾ انٿروپڪ جا ماڊل شامل آهن، جنهن بنيادي طور تي هڪ اوپن سورس ڪوڊ بيس جي سنڀاليندڙن کي ڪمزورين سان ڪوڊ قبول ڪرڻ ۾ ڳالهائڻ جي ڪوشش ڪئي.
ايڊلر چيو ته اهڙي صورتحال آساني سان ٿي سگهي ٿي AI ڪمپني جي اندروني سسٽم اندر. انهي کي روڪڻ لاءِ، هو تجويز ڪري ٿو ته ڪمپنيون پنهنجي AI سسٽم جي سوچ جي زنجير کي اسڪين ڪن - ماڊل جو قدم قدم استدلال - فريب جي نشانين کي ڏسڻ لاءِ ، ڊگهي هلڻ واري سازش ، يا ڪوڊ ۾ ڪمزورين کي متعارف ڪرائڻ جو منصوبو جنهن جو اهي بعد ۾ فائدو وٺي سگهن.
گائيڊ لائٽ جيڪي طريقا پيش ڪري رهيا آهن انهن تي عمل ڪرڻ بلڪل سادو آهي، ايڊلر چوي ٿو، ۽ ڪيترن ئي ڪيسن ۾، انهن جا نسخا اڳ ۾ ئي موجود آهن. ”اها ڪمپني جي اندر فيصلو ڪرڻ بابت آهي ته هن خطري بابت ڪافي خيال رکڻ لاءِ دائري کي ٿورو وسيع ڪرڻ لاءِ ،“ ايڊلر چيو.
مکيه چئلينجن مان هڪ اهو آهي ته محقق پنهنجي AI سسٽم اندر لچڪدار طريقي سان هلائڻ جي قابل ٿيڻ چاهيندا آهن، ۽ حقيقي وقت متعارف ڪرائڻ، بچاء واري نگراني رگڙ پيدا ڪري سگهي ٿي. "محقق بنيادي طور تي پنهنجو ڪم ڪندا آهن، ۽ جيڪڏهن ڪو مسئلو آهي، ڪنهن ٻئي کي ان کي صاف ڪرڻ بعد ۾، ۽ محققن کي ان دوران پنهنجو ڪم فلو تبديل ڪرڻ جي ضرورت ناهي،" هن چيو.
”حقيقت کان پوءِ صفائي جي نگراني“ سان مسئلو اهو آهي ته اهو محققن کي مسئلن کي حل ڪرڻ جي چوڌاري ڇڪيندو آهي. ۽ ڪجهه قسمن جي واقعن لاء، اهو تمام دير سان ٿي سگهي ٿو. مثال طور، هڪ AI هڪ ڪمپني جي ڪنٽرول سسٽم کي بند ڪري سگهي ٿو، جنهن جو مطلب آهي ته محقق هاڻي بدانتظامي کي پڪڙڻ تي وڌيڪ ڳڻپ نٿا ڪري سگهن.
AI صنعت ۾ ڪيترائي شڪايت ڪندا ته بدعنواني کي سنڀالڻ لاءِ سيٽ منصوبا ٺاهڻ بنيادي طور تي مشڪل آهي ڇاڪاڻ ته AI تمام تيز هلندي آهي؛ اڄ جا منصوبا سڀاڻي بيڪار هوندا.
ايڊلر پراڻي چوڻي کي ظاهر ڪري ٿو ته منصوبا بيڪار آهن، پر منصوبابندي لازمي آهي.
"اسان بهتر ٿينداسين جيڪڏهن ڪمپنيون ان بابت وقت کان اڳ سوچين ها، ۽ مون کي اميد آهي ته اهي آهن، جيتوڻيڪ انهن عوامي طور تي هن بابت نه ڳالهايو آهي."
xAI تبصرو ڪرڻ جي وقت ۾ جواب نه ڏنو.